แสดงบทความที่มีป้ายกำกับ การแยกพีค แสดงบทความทั้งหมด

วันอาทิตย์ที่ 10 กุมภาพันธ์ พ.ศ. 2562

XPS ตอน การแยกพีค Mo และ W (การทำวิทยานิพนธ์ภาคปฏิบัติ ตอนที่ ๙๙) MO Memoir : Sunday 9 February 2562

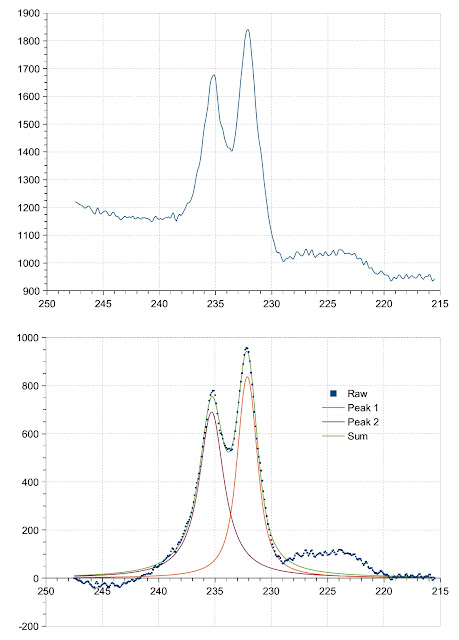
สิ่งสำคัญในการทำ peak fitting หรือ peak deconvolution คือการใช้ฟังก์ชันที่ถูกต้องกับรูปแบบการกระจายตัว (distribution) ของข้อมูล ในบางปรากฏการณ์นั้นรูปแบบการกระจายตัวอาจมีเพียงรูปแบบเดียว แต่ในหลายปรากฏการณ์นั้นรูปแบบการกระจายตัวอาจมีได้หลายรูปแบบ ขึ้นอยู่กับคุณลักษณะของตัวอย่างที่นำมาวิเคราะห์ (เช่นกรณีของสัญญาณ XRD) ดังนั้นในกรณีที่ข้อมูลนั้นอาจมีการกระจายตัวได้หลายรูปแบบ การทำ peak fitting หรือ peak deconvolution จึงควรทดสอบด้วยฟังก์ชันการกระจายตัวรูปแบบต่าง ๆ แล้วจึงค่อยพิจารณาว่ารูปแบบไหนเข้ากับข้อมูลที่มีอยู่มากที่สุด แล้วจึงค่อยเอาผลที่ได้มาใช้
 
ตัวอย่างที่นำมาแสดงในวันนี้เป็นข้อมูลการวัด XPS ของตัวเร่งปฏิกิริยา MoO3-MgO/TiO2 และ WO3-MgO/TiO2 ที่นำเสนอไปเมื่อวันศุกร์ที่ผ่านมา และได้ทำการปรับค่าพีคอ้างอิง C1s ที่ 285.0 eV แล้ว โดยในตอนที่แล้วต้องการแสดงให้เห็นถึงจำนวนรอบการสแกนที่มีผลต่อค่า signal to noise ratio โดยนำเอาข้อมูลตรงช่วง N1s มาแสดง มาคราวนี้จะเป็นการนำเอาข้อมูลช่วง Mo3d และ W4f มาทดลองทำการแยกพีค (peak deconvolution) ด้วยฟังก์ชันการกระจายตัว (distribution function) 3 ฟังก์ชันด้วยกันคือ Voigt, Doniach Sunjic และ Gaussian การคำนวณใช้โปรแกรม fityk 0.9.8
 
การคำนวณเริ่มโดยการให้โปรแกรมคำนวณหา Shirley baseline ก่อน ตามด้วยการตัด Shirley baseline (ในตัวโปรแกรม fityk 0.9.8 มีฟังก์ชันนี้อยู่แล้ว) ตามด้วยการทำให้ข้อมูลที่อยู่ข้าง ๆ พีคหลักอยู่ในรูป inactive ก่อน (เพื่อป้องกันไม่ให้ส่งผลต่อการวางตำแหน่งพีคเริ่มต้นการคำนวณ) จากนั้นจึงให้โปรแกรมทำการวางตำแหน่งพีคเริ่มต้น 2 พีค (ซึ่งจะอยู่ในบริเวณที่เป็นพีคหลัก) แล้วจึงค่อยทำการ regression 
  
Voigt function เป็นฟังก์ชันที่ส่วนลำตัวมีลักษณะที่เรียวแคบกว่า และการแผ่ลาดไปยังส่วนฐานมีลักษณะที่ค่อย ๆ แผ่ออกไป เมื่อเทียบกับ Gaussian function ฟังก็ชันนี้ในหลายกรณีพบว่าเข้ากับพีค XRD ได้ดีกว่า Gaussian function ส่วน Doniach Sunjic function นั้นเป็นฟังก์ชันที่มีลักษณะการกระจายตัวที่ไม่สมมาตร (คือถ้าแบ่งครึ่งพีคซ้าย-ขวาให้มีพื้นที่เท่ากัน จุดแบ่งครึ่งจะไม่อยู่ตรงจุดยอดพีค แต่จะอยู่ข้าง ๆ ต่ำลงมาเล็กน้อย) มีบางเว็บกล่าวว่าในบางกรณีฟังก์ชันนี้เข้ากับ line shape ของสัญญาณ XPS ได้ดีกว่าฟังก์ชันอื่น (http://www.casaxps.com/help_manual/line_shapes.htm) ก็เลยลองนำมาทดสอบด้วย
 
การที่เลือกใช้ Shirley baseline ก็เพราะดูแล้วรูสึกว่าพีคตัวอย่างที่นำมานั้นอยู่บริเวณช่วงที่ระดับ baseline ข้างซ้ายและข้างขวาอยู่ต่างระดับกัน คือมีการเปลี่ยนแปลงระดับแบบ S-curve ในบริเวณดังกล่าว (ไม่ได้เปลี่ยนแบบเป็นเส้นตรง) 
  
รูปที่ ๑ และ ๒ เป็นผลที่ได้จากการวัดและทำ peak deconvolution พีค Mo3d ในขณะที่รูปที่ ๓ และ ๔ เป็นผลที่ได้จากการวัดและทำ peak deconvolution พีค W4f ยังไงก็ลองพิจารณาดูรูปเอาเองก็แล้วกันนะครับ เห็นอย่างไรก็เป็นไปตามนั้น แต่ทั้งนี้ทั้งนั้นขอเตือนเอาไว้อย่างก็คือ วิธีการตัดเส้น baseline นั้น ไม่ว่าจะให้โปรแกรมทำให้หรือจะเลือกลากเอง สามารถส่งผลต่อผลของการทำ peak deconvolution ที่จะออกมา
 
(หมายเหตุ : สำหรับบางคนที่เพิ่มจะผ่านมาเจอ พีค XPS แต่ละพีคนั้นจะเรียกด้วยชื่อธาตุและชั้นวงโคจรของของอิเล็กตรอนที่หลุดออกมา เช่นพีค Mo3d ก็หมายถึงอิเล็กตรอนที่หลุดออกมาจากชั้นวงโคตร 3d ของธาตุ Mo ซึ่งบางทีมันก็จะมีตัวเลขต่อท้ายอีกเช่น 3d5/2 เพราะชั้น 3d มันมีหลาย orbital)

รูปที่ ๑ รูปบนเป็นสัญญาณตรงบริเวณ Mo3d ก่อนให้โปรแกรมทำการคำนวณและตัดเส้น Shirley base line ส่วนรูปล่างเป็นผลการทำ peak deconvolution ด้วยการใช้ Voigt function ในการคำนวณนั้นมีการทำให้จุดข้อมูลบริเวณส่วนฐานที่มี peak อื่นซ้อนอยู่นั้นให้เป็นจุดที่ inactive (ไม่ได้เอามาใช้ในการทำ peak fitting)

รูปที่ ๒ เป็นตอนต่อจากรูปที่ ๑ โดยรูปบนเป็นผลการทำ peak deconvolution ด้วยการใช้ Doniach Sunjic funciton ส่วนรูปล่างเป็นผลที่ได้จากการใช้ Gaussian distribution function ในกราฟทุกรูปนั้น (รูปที่ ๑-๔) แกนนอนคือค่า Binding energy (B.E.) มีหน่วยเป็น eV (electron volt) ส่วนแกนตั้งคือค่าความแรงของสัญญาณ (count)

รูปที่ ๓ รูปบนเป็นสัญญาณตรงบริเวณ W4f ก่อนให้โปรแกรมทำการคำนวณและตัดเส้น Shirley base line ส่วนรูปล่างเป็นผลการทำ peak deconvolution ด้วยการใช้ Voigt function ในการคำนวณนั้นมีการทำให้จุดข้อมูลบริเวณส่วนฐานที่มี peak อื่นซ้อนอยู่นั้นให้เป็นจุดที่ inactive (ไม่ได้เอามาใช้ในการทำ peak fitting)

รูปที่ ๔ เป็นตอนต่อจากรูปที่ ๓ โดยรูปบนเป็นผลการทำ peak deconvolution ด้วยการใช้ Doniach Sunjic funciton ส่วนรูปล่างเป็นผลที่ได้จากการใช้ Gaussian distribution function

เว็บ https://xpssimplified.com/periodictable.php ให้ค่า binding energy ของ Mo3d5/2 สำหรับบางสารประกอบไว้ดังนี้คือ Mo (เลขออกซิเดชัน 0) 228.0 eV, MoO2 (เลขออกซิเดชัน 4+) 229.5 eV และ MoO3 (เลขออกซิเดชัน 6+) 233.1 eV และในกรณีของโลหะ W เว็บเดียวกันนี้ให้ค่า binding energy ของ W4f7/2 สำหรับบางสารประกอบไว้ดังนี้คือ W (เลขออกซิเดชัน 0) 31.6 eV, WS2 (เลขออกซิเดชัน 4+) 32.4 eV, WO2 (เลขออกซิเดชัน 4+) 33.1 eV และ WO3 (เลขออกซิเดชัน 6+) 36.1 eV
 
ค่า binding energy นั้นอาจเปลี่ยนแปลงไปตามชนิดแหล่งกำเนิดรังสีเอ็กซ์ (กล่าวคือใช้ Mg หรือ Al เป็นแหล่งกำเนิดรังสี) และตำแหน่งพีคอ้างอิง (ปรกติก็มักจะเป็น C1s หรือ O1s) ดังนั้นถ้าพบว่าพีคที่วัดได้กับที่หา reference ได้นั้นมันแตกต่างกันอยู่ ก็ควรทำการตรวจสอบข้อมูลตรงจุดนี้ด้วย หรือไม่ก็ต้องลองทำการตรวจสอบตำแหน่งสัมพัทธ์ของพีคที่ปรากฏนั้นประกอบด้วย อย่างเช่นกรณีของพีค W4f ในรูปที่ ๓ และ ๔ นั้น แม้ว่าตำแหน่งจะไม่ตรงกับในรูปที่ ๕ ที่นำมาเปรียบเทียบ แต่ถ้าพิจารณาระยะหว่างระหว่างพีค W4f5/2 และ W4f7/2 แล้วจะเห็นว่าตรงกันอยู่

รูปที่ ๕ พีคต่าง ๆ ของ W4f (นำมาจาก https://xpssimplified.com/elements/tungsten.php ข้อมูล ณ วันศุกร์ที่ ๘ กุมภาพันธ์ ๒๕๖๒) จะเห็นว่าพีค W4f ของ W6+ มี 2 พีค ซึ่งเป็นของอิเล็กตรอนที่ต่าง orbital กัน ไม่ได้มาจากไอออน W ที่มีเลขออกซิเดชันต่างกัน

ผมเองก็ไม่ได้เล่นเครื่องนี้มานาน และก็ไม่ได้เป็นผู้รู้ดีอะไรมากในเรื่องนี้ บทความนี้เพียงแค่ต้องการแสดงให้เห็นว่า การแต่งผลการวิเคราะห์ด้วยเทคนิคทางคณิตศาสตร์นั้นมันสามารถกระทำได้ ขึ้นอยู่กับว่าเราจะตรวจสอบข้อมูลดิบลงไปลึกแค่ไหนเท่านั้นเอง

วันศุกร์ที่ 7 กุมภาพันธ์ พ.ศ. 2557

ทำไมพีคจึงลากหาง MO Memoir : Friday 7 February 2557

ผู้ที่ใช้เครื่องมือวิเคราะห์พวกโครมาโทกราฟ (chromatograph) หรือ Temperature Programmed Desorption (TPD) ต่าง ๆ (เช่น NH3-TPD) มักพบว่าพีคที่ได้นั้นไม่ได้มีลักษณะเป็นพีค Gaussian ที่สมมาตร แต่มีลักษณะเป็นพีค Gaussian ที่ด้านขาขึ้นมักจะชันกว่าด้านขาลง หรือเป็นพีค Gaussian ที่ไม่สมมาตร (ดูรูปที่ ๑) หรือที่เรียกว่ามีการลากหาง
  
ถ้าเป็นผลจากการวิเคราะห์ด้วยเทคนิคโครมาโทกราฟ การแปลผลว่าพีคที่ปรากฏนั้นเป็นของสารใดจะใช้เวลาที่สารนั้นหลุดออกมาจากคอลัมน์เป็นหลัก ส่วนพีคมันจะสมมาตรหรือไม่สมมาตรไม่ใช่ปัญหา ปัญหามันจะไปเกิดถ้าหากมีพีคของสารมากกว่าหนึ่งสารซ้อนทับกันอยู่ และต้องการแยกสัญญาณพีคนั้น (peak deconvolution) ว่าประกอบด้วยพีคย่อยกี่พีค ที่แต่ละพีคมีความสูงและความกว้างเท่าใด เพราะในการแยกสัญญาณพีคนั้น สิ่งแรกที่เราต้องทำก็คือกำหนดรูปร่างพีคด้วยฟังก์ชันที่เข้ากับสภาพพีคที่เป็นจริงมากที่สุด ซึ่งก็ควรเป็นฟังก์ชัน Gaussian ที่ไม่สมมาตร แต่ปัญหาที่พบเห็นประจำคือซอร์ฟแวร์ส่วนใหญ่นั้นจะใช้ฟังก์ชันเริ่มต้นเป็น Gaussian ที่สมมาตร ทำให้โครมาโทแกรมผลรวมที่เมื่อพิจารณาด้วยสายตาแล้วเห็นว่าควรมีพีคย่อยเพียงไม่กี่พีค เช่นแค่ 2 พีค แต่เมื่อทำ peak fitting ด้วยฟังก์ชัน Gaussian ที่สมมาตรกลับพบว่าต้องมีพีคย่อยเป็นจำนวนมากจึงจะสามารถปรับผลการทำ peak fitting เข้ากับข้อมูลจริงได้ ซึ่งไม่ถูกต้อง

 รูปที่ ๑ เส้นสีน้ำเงินแสดงพีค Gaussian ที่สมมาตร ส่วนเส้นสีส้มแสดงพีค Gaussian ที่ไม่สมมาตร ซึ่งเป็นลักษณะพีคการคายซับที่พบเห็นทั่วไปจากโครมาโทแกรมและการวิเคราะห์ด้วยเทคนิค Temperature Programmed Desorption (TPD) ต่าง ๆ
 
สำหรับการวิเคราะห์ด้วยเทคนิคตระกูล TPD ต่าง ๆ นั้น การแยกพีคด้วยฟังก์ชันที่ไม่เหมาะสมมักนำไปสู่การแปลผลการวิเคราะห์ที่ผิดพลาด ตัวอย่างเช่นในกรณีของ NH3-TPD ที่บ่งบอกความแรงของตำแหน่งที่เป็นกรดบนพื้นผิวของแข็งด้วยพีค NH3 ที่ปรากฏที่อุณหภูมิต่าง ๆ แม้ว่าพื้นผิวของแข็งนั้นจะมีตำแหน่งที่เป็นกรดที่มีความแรงอยู่เพียงชนิดเดียว แต่พีค NH3 ที่คายออกมาจากตำแหน่งกรดเพียงชนิดเดียวนี้ก็มีลักษณะเป็นพีค Gaussian ที่ไม่สมมาตร

สาเหตุก็เพราะของแข็งที่ดูดซับ NH3 นั้นเป็นของแข็งที่มีรูพรุน

รูปที่ ๒ แบบจำลองการคายโมเลกุลออกจากพื้นผิวของแข็ง รูปบนเป็นกรณีของของแข็งที่ไม่มีรูพรุน ส่วนรูปล่างเป็นกรณีของของแข็งที่มีรูพรุน โดยสมมุติให้พื้นผิวของแข็งดูดซับแก๊สเอาไว้ด้วยความแรงเท่ากันทุกตำแหน่ง

รูปที่ ๒ ข้างบนเป็นแบบจำลองเพื่อแสดงให้เห็นภาพ สมมุติว่าเรามีของแข็งที่มีตำแหน่งที่เป็นกรดที่มีความแรง (strength) เท่ากันหมดอยู่บนพื้นผิว เริ่มแรกนั้นเราให้พื้นผิวดูดซับโมเลกุล NH3 จนอิ่มตัวก่อน จากนั้นจึงค่อย ๆ เพิ่มอุณหภูมิของแข็งนั้นให้สูงขึ้น เมื่ออุณหภูมิสูงเพียงพอตำแหน่งที่เป็นกรดเหล่านี้จะคายโมเลกุล NH3 ที่มันจับเอาไว้พร้อมกันทั้งหมด สำหรับของแข็งที่ไม่มีรูพรุนนั้น (รูปที่ ๒ บน) โมเลกุล NH3 ที่หลุดออกมาจากพื้นผิวก็จะมาอยู่ในกระแสแก๊สที่ไหลผ่านทันที และจะถูกแก๊สพัดพาออกไปจากตัวของแข็ง โมเลกุล NH3 ในกระแสแก๊สที่พัดพามันไปจะมีการกระจายความเข้มข้นเนื่องจากการแพร่ ทำให้ความเข้มข้นของ NH3 ในกระแสแก๊สมีการกระจายแบบ Gaussian ที่สมมาตร
 
แต่ถ้าเป็นของแข็งที่มีรูพรุน (รูปที่ ๒ ล่าง) การดูดซับจะเกิดขึ้นทั้งตำแหน่งที่อยู่ใกล้ปากรูพรุนหรือภายในรุพรุน เมื่ออุณหภูมิสูงพอ ตำแหน่งเหล่านี้ก็จะปล่อยโมเลกุล NH3 ออกจากพื้นผิวพร้อม ๆ กัน แต่ในกรณีของแข็งที่มีรูพรุนนี้ โมเลกุล ที่เดิมเกาะอยู่บนพื้นผิวด้านนอกหรือใกล้กับปากรูพรุนจะแพร่เข้าสู่เฟสแก๊สที่ไหลผ่านของแข็งและถูกพัดพาออกไป แต่โมเลกุลที่อยู่ในรูพรุนจะใช้เวลามากกว่าในการแพร่ออกมาถึงปากรูพรุนและเข้าสู่กระแสแก๊สที่ไหลผ่าน ยิ่งรูพรุนมีความลึกมาก (เช่นในกรณีของอนุภาคที่มีขนาดใหญ่) แม้ว่าโมเลกุล NH3 ที่อยู่ที่ปากรูพรุนหรือที่ก้นรูพรุนจะหลุดออกมาจากพื้นผิวของแข็งที่อุณหภูมิเดียวกัน แต่โมเลกุล NH3 ที่อยู่ลึกเข้าไปในรูพรุนจะใช้เวลาเดินทางมากกว่า ทำให้ได้พีคการกระจายความเข้มข้นมีลักษณะที่เป็นพีคที่ลากหาง (คือตอนขาขึ้นนั้นขึ้นเร็ว ในขณะที่ขาลงนั้นตกลงช้ากว่าและใช้เวลานานกว่าจะหมด แบบเส้นสีส้มในรูปที่ ๑)
 
รูปที่ ๓ ในหน้าถัดไปแสดงการทดสอบการทำ peak fitting กับพีค Gaussian ที่ไม่สมมาตร (เส้นสีส้มในรูปที่ ๑ ซึ่งมีตำแหน่งจุดสูงสุดอยู่ที่ x = 4.0 และความสูง 0.9) ด้วยการใช้ฟังก์ชัน Gaussian ที่สมมาตร พีค Gaussian ที่ไม่สมมาตรในที่นี้สร้างขึ้นจากฟังก์ชัน Gaussian ที่มีพารามิเตอร์ความกว้างด้านซ้ายและด้านขวาของจุดสูงสุดของพีคที่ไม่เท่ากัน โปรแกรมที่นำมาใช้ทำ peak fitting คือ fityk version 0.9.8 จะเห็นว่าต้องใช้ฟังก์ชัน Guassian ที่สมมาตรถึง 4 ฟังก์ชันจึงสามารถปรับผลรวมฟังก์ชันให้เข้ากับพีคตั้งต้นได้ แต่ถ้าใช้ฟังก์ชัน Guassian ที่ไม่สมมาตร (ในโปรแกรม fityk เรียกว่าฟังก์ชัน SplitGuassian) พบว่าจะใช้เพียงฟังก์ชันเดียว

รูปที่ ๓ ฟังก์ชันเส้นสีส้มในรูปที่ ๑ เมื่อนำไปทำ peak deconvolution ด้วยโปรแกรม fityk 0.9.8 และใช้ฟังก์ชัน Gaussian ในการทำ peak fitting พบว่าต้องใช้ฟังก์ชัน Gaussian ถึง 4 ฟังก์ชันเพื่อจะปรับให้เข้ากับข้อมูล แต่ถ้าใช้ฟังก์ชัน Gaussian ที่ไม่สมมาตร (โปรแกรมดังกล่าวเรียก SplitGaussian) พบว่าจะใช้เพียงฟังก์ชันเดียวเท่านั้น

การที่สารที่อยู่ในรูพรุนต้องใช้เวลาในการแพร่ออกมาสู่ของไหลที่ไหลผ่านอยู่ภายนอกก็เป็นคำอธิบายว่าทำไมในการวิเคราะห์ด้วยเครื่องแก๊สโครมาโทกราฟ เวลาที่ใช้ packed column ที่ใช้อนุภาคขนาดใหญ่ พีคที่ได้จึงมีการลากหางมาก แต่พอเป็น capillary column กลับได้พีคที่มีความแหลมคมมาก เพราะ capillary column นั้นไม่ได้ใช้อนุภาคของแข็งที่มีการกระจายขนาดอนุภาคในการดูดซับอย่างที่ packed column ใช้ แต่ใช้ชั้นฟิล์มที่มีความบางกว่ามากและมีความสม่ำเสมอมากกว่า สำหรับแก๊สโครมาโทกราฟ เราสามารถลดการลากหางได้ด้วยการเพิ่มอุณหภูมิของ oven ให้ไต่ขึ้นเรื่อย ๆ ในระหว่างการวิเคราะห์

แต่ก็มีเหมือนกันที่จะเห็นพีคที่ปรากฏในโครมาโทแกรมที่มีด้านขาขึ้นลาดชันน้อยกว่าด้านขาลง เช่นในกรณีของพีคขนาดเล็กจาก capillary column ที่ออกมาในขณะที่มีการเพิ่มอุณหภูมิคอลัมน์ให้สูงขึ้นอย่างต่อเนื่องในระหว่างการวิเคราะห์

วันศุกร์ที่ 13 กันยายน พ.ศ. 2556

ค่า signal to noise ratio ที่ต่ำที่สุด MO Memoir : Friday 13 September 2556

เครื่อง XPS ที่ใช้ในแลปเรานั้นมันวัดค่าสัญญาณเป็นจุด ๆ ไม่ต่อเนื่อง แต่ตอนแสดงผลนั้นมันลากเส้นเชื่อมจุดต่าง ๆ มาให้ ทำให้ดูเหมือนว่าเป็นสัญญาณต่อเนื่อง แต่จะว่าไปแล้วไม่ว่าเป็นเครื่องมือวัดชนิดใดก็ตามในแลปเรา (เช่น XPS - x-ray photoelectron sepctroscopy, TGA - thermogravimetric analysis หรือ GC - gas chromatograph) ถ้าเราเอาเส้น base line มาขยาย ก็จะเห็นเป็นจุดเต้นไปมา เอาแน่เอานอนไม่ได้ที่เราเรียกว่าสัญญาณรบกวนหรือ noise ขนาดของการเต้นไปมานั้นก็จะอยู่ในระดับหนึ่ง ขึ้นกับความไวของตัวตรวจวัดและการปรับแต่งเครื่อง ดังนั้นในการอ่านสัญญาณนั้นจำเป็นที่ต้องไม่พิจารณาการเต้นไปมาเหล่านี้ว่าเป็นสัญญาณพีค (peak) 
  
และโดยปรกติแล้วการจะอ่านว่าอะไรเป็นพีคนั้นมันมีปัจจัยที่สำคัญอย่างน้อย ๒ ปัจจัยที่ต้องพิจารณาคือ
 
๑. ความถี่ในการวัด (หรือระยะห่างระหว่างจุดที่วัด) ต้องแคบกว่าความกว้างของพีค (ระยะห่างระหว่างจุดที่วัดไม่ควรจะมากกว่า 1/4 ของความกว้างพีค แต่ถ้าได้แคบกว่านี้ก็ยิ่งดี)
 
๒. ขนาดการเปลี่ยนแปลงนั้นไม่ควรจะน้อยกว่า 2 เท่าของสัญญาณ noise โดยค่าอัตราส่วนขนาดการเปลี่ยนแปลงต่อขนาดสัญญาณ noise นี้เรียกว่า signal to noise ratio หรือ S/N


รูปที่ ๑ ผลการวัดด้วยเครื่อง XPS เส้นสีเขียวในแนวดิ่งคือขนาดของของการเต้นไปมาของเส้น base line หรือขนาดของ noise นั่นเอง


รูปที่ ๒ เขาบอกว่ามี "พีค" ที่ตำแหน่ง 336.5 eV (ในวงส้ม)

จากประสบการณ์การอ่านสัญญาณเส้น base line นั้น (จำเป็นมากสำหรับการอ่านพีคเล็ก ๆ) การเต้นไปมานั้นมีทั้งพวกที่เต้นไปมาด้วยความถี่สูงตามความถี่ของการวัดสัญญาณ และพวกที่มีการเต้นไปมาที่ความถี่ที่ต่ำกว่า (หลากหลายสาเหตุ) ที่ทำให้เห็นค่าเฉลี่ยของเส้น base line นั้นไม่เป็นเส้นตรง ดังนั้นในการอ่านพีคโดยเฉพาะพีคเล็ก ๆ จึงต้องระมัดระวังมาก คือต้องไม่นำการเปลี่ยนแปลงเหล่านี้มาพิจารณา
 
ยิ่งเป็นเครื่องวิเคราะห์ที่ไว (sensitive) และ/หรือตัวอย่างที่ไวต่อการปนเปื้อน โดยเฉพาะอย่างยิ่งจากอากาศ ยิ่งจำเป็นระมัดระวังในการอ่านผล เพราะสัญญาณที่เห็นนั้นอาจสัญญาณของสิ่งปนเปื้อนก็ได้

รูปที่ ๑ เป็นรูปที่ผมเห็นมานานแล้ว ส่วนรูปที่ ๒ เพิ่งจะได้เห็นในวันนี้ ทั้งสองรูปเป็นผลการวิเคราะห์ด้วยเครื่อง XPS เครื่องเดียวกัน โดยในรูปที่ ๑ นั้นเขาต้องการให้มีพีค N1s (สัญญาณของ nitrogen) ส่วนรูปที่ ๒ นั้นเขาต้องการให้มีพีคที่ตำแหน่ง 336.5 eV

ที่เหลือก็คงไม่ต้องกล่าวอะไรมากแล้ว ขอให้เป็นหน้าที่ของพวกคุณลองพิจารณาเอาเอง

วันอังคารที่ 20 สิงหาคม พ.ศ. 2556

MO ตอบคำถาม การแยกพีค GC ด้วยโปรแกรม fityk MO Memoir : Tuesday 20 August 2556

เรื่องมันเริ่มจากเมื่อประมาณสองสัปดาห์ที่แล้วมีอีเมล์มาปรึกษาเรื่องการแยกพีคไนโตรเจนกับออกซิเจน โดยเขาบอกว่าก่อนหน้านี้มันก็พอจะแยกกันได้บ้างแม้ว่าจะมีการเหลื่อมซ้อนกันอยู่ แต่อยู่ดี ๆ มันก็ไม่แยกเอาซะดื้อ ๆ โดยพีคออกมาเร็วขึ้น ตอนที่เขาอีเมล์มาถามนั้นผมก็ตอบกลับไปว่าอยากเห็นโครมาโทแกรมหน่อยว่าหน้าตามันเป็นอย่างไร และก็บอกให้แวะมาคุยที่ห้องทำงานผมก็ได้เพราะตึกก็อยู่ใกล้ ๆ กัน

ตรงที่ผมบอกว่าให้แวะมาคุยกันที่ห้องทำงานก็ได้เพราะตึกก็อยู่ใกล้ ๆ กัน ดูเหมือนจะทำเอาเขางงไปเหมือนกันว่าผมรู้ได้อย่างไรว่าเขาเป็นใคร อยู่ที่ไหน วันที่เขาแวะมาหาเขาก็ถามผมเรื่องนี้ ผมก็เลยบอกเขาไปว่าก็เอาอีเมล์ของคุณใส่ลงไปใน google แล้วมันก็ขึ้นมาว่าคุณเคยไปโพสอะไรไว้ที่ไหนบ้าง หรือใช้อีเมล์นี้เปิด facebook หรือไม่

ก่อนหน้านี้ผมได้ตอบเขาไปว่าไนโตรเจนและออกซิเจนเป็นคู่หนึ่งที่แยกยาก เพราะขนาดโมเลกุลใกล้กันและจุดเดือดก็ใกล้กัน คอลัมน์บางชนิดแยก "อากาศ" ออกจากแก๊สตัวอื่น เช่น CO CO2 และ Ar ได้ แต่ไม่แยก N2 และ O2 ที่เคยเห็นในแคตตาล็อกขายคอลัมน์ GC บางคอลัมน์ที่เขาบอกว่าแยกได้นั้นจะกระทำที่อุณหภูมิไม่สูง เช่นประมาณ 20 หรือ 25ºC ซึ่งในบ้านเราแล้วอุณหภูมินี้มันต่ำกว่าอุณหภูมิห้องอีก ถ้าจะนำเอาคอลัมน์แบบนี้มาใช้ก็ต้องเพิ่มความยาวให้มากกว่าที่เขาระบุไว้ในแคตตาล็อก หรือไม่ก็หาทางทำให้เครื่อง GC นั้นทำให้คอลัมน์มีอุณหภูมิต่ำกว่าอุณหภูมิห้องให้ได้ คอลัมน์ที่เขาใช้คือ micropacked 13X Molecular sieve 80/100 2m 1.00 I.D. วิเคราะห์ที่ 28ºC ซึ่งตรงนี้เขาบอกว่าเขาทำแลปในห้องแอร์ที่แอร์เย็น เครื่อง GC ก็เลยทำงานที่อุณหภูมินี้ได้

อีกอันหนึ่งที่แนะนำเขาไปคือให้ลองปรับ carrier gas flow rate ให้ต่ำลง แต่ถ้าทำแบบนี้กับ TCD ก็ต้องไปทำ calibration curve ใหม่ด้วย

หลังจากพบกันแล้วเขาก็ไปทดลองปรับอัตราการไหลของ carrier gas ให้ลดลง ซึ่งก็ทำให้เวลาที่พีคออกมานั้นออกมาที่เวลาเดิมก่อนมีปัญหา แต่ก็ยังมีการเหลื่อมซ้อนกันอยู่ดี จนกระทั่งวันศุกร์ที่แล้วก็ได้ส่งรูปพีคและไฟล์ .txt และ .csv มาให้ ผมเห็นรูปพีคของเขาแล้ว (ดูรูปที่ ๑) ก็เห็นว่าไม่น่าจะมีปัญหาอะไรมากในการใช้โปรแกรม fityk ในการแยกพีค (ถ้าใช้โปรแกรมเป็นแล้วนะ) พีคทั้งสองนั้นวางตัวอยู่บน base line ที่ค่อนข้างจะวางตัวราบ (แทบไม่มีการเฉียงขึ้นหรือลง) ไม่มีการปรากฏของพีคอื่นข้างเคียง ก็เลยเอาข้อมูลของเขามาทำการแยกพีคด้วยโปรแกรม fityk เล่นดู

อันที่จริงวิธีการทำ peak fitting นั้นทำได้หลายรูปแบบ ในกรณีที่พีคออกมาค่อนข้างจะชัดเจนนั้นเราสามารถให้โปรแกรมทำการเติมฟังก์ชันลงไปที่แต่ละพีคและทำ peak fitting ได้เลย แต่ในกรณีที่พีคมีการเหลื่อมซ้อนกันนั้น เท่าที่พบนั้นบางครั้งเราก็สามารถให้โปรแกรมทำการวางตำแหน่งพีคสำหรับพีคย่อยแต่ละพีคลงไปก่อน แล้วค่อยทำ peak fitting ทีเดียว แต่บ่อยครั้งเหมือนกัน โดยเฉพาะกรณีที่พีคเล็กมีจุดเริ่มต้นและจุดสิ้นสุดอยู่บนหางพีคใหญ่หรือซ้อนกับพีคใหญ่อยู่มาก จำเป็นต้องทำ peak fitting ทีละพีค โดยเลือกเอาเฉพาะข้อมูลส่วนที่คิดว่าเป็นของพีคใดพีคหนึ่งเท่านั้นมาทำ peak fitting ก่อน จากนั้นจึงทำการตรึงพีคที่ได้ แล้วจึงทำ peak fitting ส่วนที่เหลือ

จากข้อมูลที่เขาให้ผมมาในรูปที่ ๑ นั้น ผมลองทำการเติมพีคและทำ peak fitting โดยตรงโดยไม่ต้องไปยุ่งอะไรกับข้อมูลเดิมก็พบว่ามันทำได้ แต่ที่จะเอามาเล่าให้ฟังในบันทึกนี้ผมจะใช้วิธีแยกทำ peak fitting ทีละพีค เนื่องจากผมไม่ต้องการย่อรูปให้เล็กลง ดังนั้นคำบรรยายรูปจะแยกออกจากรูปแต่ละรูป
  
รูปที่ ๑ เป็นไฟล์ข้อมูลที่ผมได้รับมาในรูปไฟล์ .csv และนำมาเปิดด้วยโปรแกรม fityk ลักษณะเป็นพีคเล็กนำหน้าพีคใหญ่ โดยส่วนหางของพีคเล็กนั้นซ้อนทับอยู่กับส่วนหน้าของพีคใหญ่

รูปที่ ๑ โครมาโทแกรมที่ได้รับมา เมื่อเปิดด้วยโปรแกรม fityk

รูปที่ ๒ เป็นภาพขยายบริเวณส่วนฐานของพีค จะเห็นว่าในความเป็นจริงเส้น base line มีการเคลื่อนตัวไต่ขึ้นอย่างช้า ๆ โดยข้อมูลส่วนหน้านั้นติดลบเล็กน้อย ส่วนข้อมูลส่วนหลังนั้นมีค่าเป็นบวก
  
เนื่องจากฟังก์ชันที่เราใช้ในการทำ peak fitting นั้นเป็นฟังก์ชันที่มีค่าเป็นบวกเสมอ (เรามักใช้ฟังก์ชันที่โปรแกรม fityk เรียกว่า "SplitGaussian" ซึ่งเป็นฟังก์ชัน Gaussian ที่ไม่สมมาตรนั่นเอง) ถ้าหากข้อมูลที่นำมาทำ peak fitting นั้นมีค่าติดลบ จะทำให้โปรแกรมทำการเติมพีคที่ "กลับหัว" เข้าไป วิธีการป้องกันคือทำการ "ยก" ข้อมูลในมีค่าเป็นบวกทั้งหมดก่อน แต่ในขณะเดียวกันนั้นฟังก์ชันที่เราใช้นั้นจะลู่เข้าหาศูนย์ แต่ไม่ตัดกัน x ดังนั้นการตัด base line จึงควรให้บริเวณที่ใกล้กับฐานของพีคนั้นมากกว่าศูนย์เล็กน้อย แต่อย่ามากเกินไป เพราะจะทำให้โปรแกรมทำการเติมพีคที่มีความสูงน้อย แต่ความกว้างมากเข้ามา พีคนี้จะเป็นพีคตัวแทนของเส้น base line

ในรูปที่ ๒ ผมจึงตัดโดยตามแนวเส้นสีแดงที่แสดงในรูป (ใช้ปุ่มวางเส้น base line ในการวางแนวเส้น base line)

รูปที่ ๒ ภาพขยายโครมาโทแกรมในรูปที่ ๑ บริเวณเส้น base line และแนวการตัดเส้น base line (เส้นสีแดง)

รูปที่ ๓ เป็นรูปหลังจากตัดเส้น base line แล้ว รูปนี้เป็นการเลือกจุดข้อมูลที่คาดว่าเป็นเฉพาะของพีคแรกเท่านั้น โดยการกดปุ่มที่ลูกศร (1) ชี้ จากนั้นใช้เมาส์กำหนดจุด การทำให้จุดข้อมูลที่ไม่ต้องการเป็นจุด inactive ทำโดยการกดปุ่มด้านขวาของเมาส์ค้างไว้แล้วลากเมาส์ไปตามจุดข้อมูลเหล่านั้น จุดข้อมูลที่เป็น inactive จะกลายเป็นจุดสีเทา ในที่นี้ผมทำให้จุดข้อมูลช่วงเวลาประมาณก่อน 2.00 นาทีและหลัง 2.75 นาทีเป็นจุดที่ inactive จุดก่อนเวลา 2.00 นาทีเป็นช่วงที่ยังไม่มีพีคปรากฏ ส่วนช่วงเวลาถัดจ่าก 2.75 นาทีนั้นเป็นจุดข้อมูลที่เป็นผลรวมระหว่างส่วนท้ายของพีคเล็กและส่วนหน้าของพีคใหญ่ ในขณะที่จุดข้อมูลในช่วงเวลา 2.00 - 2.75 นาทีนั้นประมาณว่าเป็นของพีคเล็กเท่านั้น


รูปที่ ๓ การเลือกจุดข้อมูลที่คาดว่าเป็นของเฉพาะพีคแรก (ในกรอบสีแดง) เพื่อทำการสร้างพีคแรกขึ้นมาก่อน

รูปที่ ๔ เป็นการทำ peak fitting ของพีคแรก โดยเลือกฟังก์ชันที่นำมาใช้ในการทำ peak fitting จากช่องตรงลูกศร 1 ชี้ การเลือกฟังก์ชันนั้นต้องเหมาะสมกับชนิดของพีค ในกรณีของโครมโทแกรมนั้นเนื่องจากพีคมักจะไม่สมมาตร จึงเลือกใช้ฟังก์ชันที่โปรแกรม fityk เรียกว่า SplitGaussian ซึ่งอันทีจริงก็คือฟังก์ชัน Gaussian นั่นเอง แต่เป็นฟังก์ชันที่มีความกว้างด้านซ้ายและด้านขวาแตกต่างกัน (ถ้าเท่ากันมันก็จะเป็นฟังก์ชัน Gaussian)

จากนั้นก็ให้โปรแกรมวางตำแหน่งพีคให้ด้วยการกดที่ icon ที่ลูกศร 2 ชี้ ถ้าพบว่าตำแหน่งและ/หรือรูปร่างพีคที่โปรแกรมวางให้นั้นไม่ถูกใจเรา เรายังสามารถปรับแต่งรูปร่างของพีคที่โปรแกรมวางให้ด้วยการใช้เมาส์ไปปรับที่ตัวพีคโดยตรงได้ การวางพีคนี้ต้องดูรูปร่างพีคเป็นหลัก บางครั้งวางพีคเดียวก็พอ แต่บางครั้งก็ต้องวางหลาย ๆ พีคหน่อย ตรงนี้ต้องทดลองทำเอาเอง อย่างเช่นในทีนี้พบว่าวางเพียงพีคเดียวก็พอแล้ว ก็ไปกด icon ที่ลูกศร 3 ชี้เพื่อให้โปรแกรมทำ peak fitting การกด icon นี้สามารถกดได้หลายครั้งจนกว่าจะพบว่ามันเข้าที่ ในที่นี้จะได้พีคที่เป็นเส้นสีน้ำเงิน และมีรายละเอียดตำแหน่งพีคปรากฏในแทป function ตรงลูกศร 4 ชี้ ส่วนรายละเอียดของพีคเช่นข้อมูลพารามิเตอร์ พื้นที่ ความสูง จะอยู่ข้างล่างตรงกรอบสีแดงที่ลูกศร 5 ชี้

เมื่อได้รูปร่างพีคแรกแล้วก็ทำการตรึงพีคนี้ไว้ เพื่อไม่ให้เกิดการเปลี่ยนแปลงใด ๆ ในการทำ peak fitting ให้กับพีคที่สอง การตรึงพีคนั้นทำได้โดยการไปกดเลือกพีคที่ต้องการตรึง (ในกรอบที่ลูกศร 4 ชี้) จากนั้นไปกดที่ icon ที่เป็นรูปแม่กุญแจข้างล่าง (ตรงกรอบสีน้ำเงินที่ลูกศร 6 ชี้) ทุกตัว มันจะเปลี่ยนจากเปิดอ้างอยู่เป็นล็อค การทำเช่นนี้จะทำให้พีคที่ทำการล็อกเอาไว้แล้วถูกตรึงเอาไว้ ไม่เกิดการเปลี่ยนแปลงใด ๆ ในการทำ peak fitting ในขั้นตอนถัดไป
 
รูปที่ ๔ การทำ peak fitting ของพีคแรก

รูปที่ ๕ เป็นการทำ peak fitting ให้กับพีคที่สอง เนื่องจากพีคนี้ค่อนข้างใหญ่ทำให้บ่อยครั้งการใช้ peak เพียงพีคเดียวไม่สามารถที่จะปรับเข้ากับข้อมูลดิบได้หมด จึงมักต้องทำการเติมเข้าไปหลายพีค การเติมเข้าไปหลายพีคนั้นทำได้หลายแบบ เช่นอาจเพิ่มพีคเข้าไปจำนวนหนึ่งก่อนจนเห็นว่ามันใกล้เคียงข้อมูลดิบ จากนั้นจึงค่อยกดไอคอนให้โปรแกรมเริ่มกระบวนการ peak fitting หรืออาจทำการเติมพีคเข้าไปก่อนหนึ่งพีค กดไอคอนให้โปรแกรมทำ peak fitting แล้วจึงค่อยเพิ่มพีคที่สอง กดไอคอนให้โปรแกรมทำ peak fitting ถ้าเห็นว่าผลที่ออกมายังไม่ดีก็เพิ่มพีคที่สามและทำเช่นนี้ต่อไปเรื่อย ๆ ตรงจุดนี้ต้องลองดูกับข้อมูลของตัวเอง แม้แต่ข้อมูลเดียวกันถ้าตัดเส้น base line ต่างกันก็อาจทำให้กระบวนการ peak fitting เพื่อให้พีครวมออกมาดูดีนั้นแตกต่างกันไปได้ แต่ถ้าคำนวณพื้นที่รวมของทุกพีคแล้วมักจะเห็นว่าพอ ๆ กัน
 
ในกรณีของพีคที่สองในรูปที่ ๕ นั้น ผมใช้การเติมเข้าไปทีละพีคและทำ peak fitting จากนั้นจึงค่อยเติมพีคที่สองและทำ peak fitting จากนั้นจึงเติมพีคที่สามและทำ peak fitting ก็พบว่าพีครวมที่ได้ปรับเข้ากับข้อมูลดิบได้ดี ดังนั้นพื้นที่พีคของพีคหลังจะคำนวณได้จากผลรวมของพื้นที่พีคที่เวลา 3.08811 นาที 3.15324 นาที และ 3.21724 นาที พึงสังเกตว่าแม้ว่าจะมีต้องใช้พีคถึงสามพีค แต่ตำแหน่งยอดพีคของทั้งสามพีคนั้นอยู่ประมาณเวลาเดียวกัน อันนี้เป็นไปได้ว่าแต่ละพีคนั้นเป็นตัวแทนของการคายออกมาจากอนุภาค (packing material ที่อยู่ในคอลัมน์) ที่มีขนาดต่าง ๆ กัน

รูปที่ ๕ การทำ peak fitting พีคที่สอง

เมื่อได้พีคที่สองแล้วก็ควรทำการตรวจสอบด้วยว่าการทำ peak fitting นั้นยอมรับได้หรือไม่ สิ่งที่ผมทำเป็นปรกติก็คือทำการลบพีคแรกทิ้งแล้วดูว่าผลรวมของฟังก์ชันที่ใช้ในการประมาณค่าพีคที่สองนั้นเข้ากับข้อมูลดิบหรือไม่ รูปที่ ๖ เป็นรูปที่ได้ลบฟังก์ชันของพีคแรกทิ้งไป เส้นสีน้ำเงินคือเส้นผลรวมของพีค 3 พีคที่ใช้ในการประมาณค่าพีคที่สอง ซึ่งก็พบว่าปรับเข้ากับข้อมูลดิบได้ดี
 
รูปที่ ๖ รูปร่างของพีคที่สองเมื่อทำการลบพื้นที่หนึ่งทิ้งไป
 
เนื่องจากขนาด packing material ใน packed column นั้นไม่ได้มีขนาดเท่ากันทุกอนุภาค แต่มีการกระจายตัวของขนาดอนุภาคอยู่ สารที่ถูกดูดซับเอาไว้ในรูพรุนของอนุภาคขนาดเล็กจะหลุดออกมาได้ง่ายกว่าสารที่ถูกดูดซับเอาไว้ในรูพรุนของอนุภาคขนาดใหญ่ เพราะรูพรุนของอนุภาคขนาดเล็กนั้นมีเส้นทางที่สั้นกว่าทำให้ใช้เวลาน้อยกว่าในการแพร่จากข้างในรูพรุนออกมายัง carrier gas ส่วนที่ทำให้พีคเกิดการลากหางจึงเป็นส่วนของสารที่หลุดออกมาจากรูพรุนของอนุภาคขนาดใหญ่ ด้วยเหตุนี้พีคที่ได้นั้นจึงมีลักษณะที่ไม่สมมาตร การใช้ฟังก์ชันที่สมมาตรเช่น Gaussian จะใช้ทำให้ต้องใช้พีคประมาณค่าจำนวนมากจึงจะปรับพีครวมให้เข้ากับข้อมูลดิบได้ การใช้ฟังก์ชัน Gaussian เช่นฟังก์ชันที่เรียกว่า SplitGaussian ของโปรแกรม fityk จะทำให้ใช้พีคประมาณค่าจำนวนน้อยกว่า และปรับเข้ากับข้อมูลดิบได้ดีกว่า

ที่เขียนมาทั้งหมดนั้นเป็นแค่แนวทางหนึ่งในการทำ peak fitting ให้กับโครมาโทแกรมเท่านั้นเอง ไม่ได้หมายความว่าต้องปฏิบัติตามที่เขียนมาข้างต้นเสมอไป สิ่งที่ผู้ปฏิบัติควรทำก็คือปรับวิธีการให้เหมาะสมกับข้อมูลของตนเองและควรอธิบายได้ว่าทำไมจึงต้องทำเช่นนั้น

วันเสาร์ที่ 22 กันยายน พ.ศ. 2555

ความสัมพันธ์ระหว่างค่าการดูดกลืนแสง (Absorbance) กับความเข้มข้น MO Memoir : Saturday 22 September 2555

เนื้อหาในบันทึกฉบับนี้เกี่ยวข้องกับบันทึกก่อนหน้านี้ ๒ ฉบับคือ
ปีที่ ๓ ฉบับที่ ๒๖๐ วันพุธที่ ๑๖ กุมภาพันธ์ ๒๕๕๔ เรื่อง "Distribution functions"
ปีที่ ๓ ฉบับที่ ๒๖๓ วันพฤหัสบดีที่ ๒๒ กุมภาพันธ์ ๒๕๕๔ เรื่อง "UV-Vis - peak fitting"

เรื่องทั้งเรื่องมันเริ่มจากเมื่อประมาณ ๒ สัปดาห์ที่แล้ว ระหว่างนั่งฟังการนำเสนอวิธีการการแยกสารธรรมชาติจากพืชสมุนไพร ผู้บรรยายได้เล่าถึงวิธีการที่เขาใช้ในการหาปริมาณสารสกัดที่ได้ซึ่งใช้เทคนิคการวัดการดูดกลืนคลื่นแสงที่ความยาวคลื่นหนึ่ง ซึ่งผมเห็นว่าวิธีการที่เขาเลือกใช้นั้นมันมีประเด็นที่ต้องพิจารณาให้ดี เพราะสามารถส่งผลต่อการแปลผลการทดลองที่ได้

แต่ก่อนอื่นเราลองมาทบทวนเรื่องการวัดการดูดกลืนคลื่นแสงกันสักหน่อยดีกว่า

การใช้เทคนิคการวัดการดูดกลืนคลื่นแสงเป็นเทคนิคที่มีการนำมาใช้ในการระบุชนิดของสารและวัดความเข้มข้น ของสารในสารละลาย (ส่วนใหญ่ก็เป็นสารละลายในน้ำ) ช่วงความยาวคลื่นของแสงที่มีการใช้กันมากในการวัดความเข้มข้นคือแสงช่วง UV-Vis

ในการวัดความเข้มข้นนั้น ผู้ทำการทดลองจะต้องทำการทดสอบก่อนว่าตัวอย่างที่ต้องการวัดนั้นดูดกลืนคลื่นแสงที่ความยาวคลื่นใดมากที่สุด (หาตำแหน่งการดูดกลืนที่เด่นชัด) ซึ่งทำได้โดยการนำเอาสารตัวอย่างนั้นไปวัดการดูดกลืนคลื่นแสงที่ความยาวคลื่นต่าง ๆ จากนั้นจะใช้ความยาวคลื่นที่พบการดูดกลืนที่เด่นชัดที่สุดนั้นเป็นตำแหน่งความยาวคลื่นที่จะวัดความเข้มข้นของสารตัวอย่าง

ถ้าให้ I0 คือความเข้มของแสงที่ส่องออกมาจากแหล่งกำเนิด I คือความเข้มของแสงที่ส่องผ่านสารตัวอย่าง ค่าการส่องผ่าน (Transmittance - T) ซึ่งนิยมรายงานผลในรูปของร้อยละ จะคำนวณได้จากสมการ

%T = I/I0 x 100
 
อีกหน่วยหนึ่งที่นิยมใช้กันในการรายงานผลคือค่าการดูดกลืน (Absorbance - A) ซึ่งคำนวณได้จากสมการ

A = log (I0/I)
 
ค่า %T และ A สัมพันธ์กันตามสมการ

A = 2 - log(%T)

ต่อไปเราจะลองพิจารณาดูความสัมพันธ์ระหว่าง ระยะทางที่แสงเดินทางผ่านตัวอย่างหรือความเข้มข้นของตัวอย่าง กับค่า %T หรือ A
 
ในการดูดกลืนคลื่นแสงนั้น ปริมาณแสงที่ถูกดูดกลืนจะไม่ขึ้นอยู่กับความเข้มของแสงที่ตกกระทบ แต่จะขึ้นอยู่กับระยะทางที่แสงเดินทางผ่านหรือความเข้มข้นของสารตัวอย่าง กล่าวคือสมมุติว่าถ้าเราให้แสงเดินทางผ่านตัวอย่างเป็นระยะทาง 1 หน่วยแล้วพบว่าแสงผ่านได้เพียง 50% (%T = 50%) ดังนั้นถ้าเราให้แสงเดินทางผ่านตัวอย่างเป็นระยะทาง 2 หน่วย แสงที่ผ่านออกมาก็จะเหลือเพียง 25% (%T = 25%) และถ้าแสงต้องเดินทางผ่านตัวอย่างเป็นระยะทาง 3 หน่วยความเข้มของแสงที่ผ่านออกมาก็จะเหลือเพียง 12.5 % (%T = 12.5%) (ดูรูปที่ ๑ (บน) ประกอบ ถ้าเปลี่ยนระยะทางเป็นความเข้มข้นก็จะให้ผลแบบเดียวกัน) ดังนั้นถ้าเราเขียนกราฟระหว่างระยะทาง/ความเข้มข้นกับ %T หรือ A ก็จะได้กราฟดังรูปที่ ๑ (ล่าง)

รูปที่ ๑ (บน) ตัวอย่างการลดลงของความเข้มของแสงเมื่อต้องเดินทางผ่านตัวกลาง (ล่าง) กราฟความสัมพันธ์ระหว่าง ระยะทาง/ปริมาณ กับค่า %Transmittance และ Absorbance

จากรูปที่ ๑ จะเห็นว่าความสัมพันธ์ระหว่างระยะทาง/ปริมาณกับค่าการดูดกลืน A นั้นมีความสัมพันธ์ที่เป็นเส้นตรงที่ดีกว่าความสัมพันธ์ระหว่างระยะทาง/ปริมาณกับค่าร้อยละการส่องผ่าน (%T) ดังนั้นในการวิเคราะห์เชิงปริมาณจึงนิยมวัดการดูดกลืนในรูปของ A มากกว่า %T

ทฤษฎีที่นำมาใช้กันในการหาความสัมพันธ์ระหว่างปริมาณแสงที่ส่องผ่านสารตัวอย่างหรือถูกสารตัวอย่างดูดกลืนและปริมาณสารตัวอย่างนั้นได้แก่กฎของเบียร์-แลมเบิร์ต (ฺBeer-Lambert's Law) ซึ่งบ่อยครั้งมักจะเรียกสั้น ๆ ว่ากฎของเบียร์ (Beer's Law) ซึ่งกล่าวว่า

A = e.b.c
 
เมื่อ e คือค่าคงที่การดูดกลืนคลื่นแสงซึ่งขึ้นอยู่กับความยาวคลื่นและชนิดของสาร b คือระยะทางที่แสงเดินทางผ่านซึ่งโดยปรกติในการวัดนั้นระยะทางนี้จะคงที่ และ c คือความเข้มข้นของสาร ดังนั้นถ้าจะว่าตามกฎของเบียร์แล้ว สำหรับสารหนึ่งที่มีค่า e คงที่และการวัดการดูดกลืนแสงด้วยเครื่องมือที่มีค่า b คงที่ ความเข้มข้นของแสงควรแปรผันตรงกับค่าการดูดกลืนคลื่นแสงที่วัดได้ ซึ่งในความเป็นจริงความสัมพันธ์ที่เป็นเส้นตรงดังกล่าว (ระหว่างระยะทาง/ปริมาณกับค่า A ดังที่แสดงในรูปที่ ๑) จะใช้ได้ดีในกรณีที่สารตัวอย่างมีความเข้มข้นไม่สูงมากเกินไปและไม่ต่ำเกินไป เพราะที่ความเข้มข้นสูงมากเกินไปหรือต่ำเกินไปจะมีการเบี่ยงเบนเกิดขึ้น โดยบางรายงานนั้นกล่าวว่าช่วงที่ความสัมพันธ์มีความเป็นเส้นตรงที่ดีนั้นคือช่วงที่ค่า A อยู่ระหว่าง 0.2-0.8

ดังนั้นในการวิเคราะห์เชิงปริมาณ (quantitative analysis) เพื่อตัดปัญหาเรื่องความสัมพันธ์ที่ไม่เป็นเส้นตรง จึงควรใช้ calibration curve เป็นตัวบ่งบอกปริมาณ แทนที่จะใช้กฎของเบียร์
 
ในการสร้าง calibration curve นั้นผู้ทำการทดลองต้องทำการเตรียมสารละลายมาตรฐานที่ความเข้มข้นต่าง ๆ กัน และนำมาวัดค่าการดูดกลืน (A) จากนั้นจึงสร้างกราฟความสัมพันธ์ระหว่างค่าการดูดกลืน (A) และความเข้มข้นของสาร และใช้กราฟดังกล่าวในการหาความเข้มข้นของสารที่ต้องการวัดในสารตัวอย่าง

นี่คือประเด็นที่เราจะคุยกันใน Memoir ฉบับนี้

ประเด็นคำถามที่ผมยกขึ้นมาในการบรรยายดังกล่าวคือ ในการค่าการดูดกลืนนั้น ผู้ทำการทดลองเลือกใช้ค่าที่ได้จากการวัดที่ค่าความยาวคลื่นใดความยาวคลื่นหนึ่งเพียงค่าเดียวเท่านั้น โดยไม่ได้มีการพิจารณาภาพสเปกตรัมโดยรวม การใช้การวัดที่ค่าความยาวคลื่นเฉพาะเพียงค่าเดียวนั้นใช้ได้ดีในกรณีที่สารตัวอย่างของเราเป็นสารบริสุทธิ์ แต่ถ้าหากสารตัวอย่างของเรานั้นมีสารอื่นปนอยู่ด้วย และสารเหล่านั้นก็ให้ค่าการดูดกลืนคลื่นแสงที่ความยาวคลื่นใกล้เคียงกัน 
 
คำถามก็คือการดูดกลืนคลื่นแสงที่ความยาวคลื่นข้างเคียงนั้นส่งผลต่อค่าการดูดกลืนของความยาวคลื่นแสงที่เราต้องการวัดหรือไม่

เวลาที่เราบอกว่าสารใดสารหนึ่งให้พีคการดูดกลืนคลื่นแสงที่ความยาวคลื่นใดนั้น เช่นสมมุติว่าให้พีคที่ 380 nm ก็ไม่ได้หมายความว่าสารนั้นจะดูดกลืนคลื่นแสงที่เฉพาะความยาวคลื่น 380 nm และที่ความยาวคลื่นข้าง ๆ (เช่น 381 หรือ 379 nm) จะไม่มีการดูดกลืน แต่มันหมายความว่าพีคการดูดกลืนนั้นมีจุดสูงสุดที่ตำแหน่งความยาวคลื่น 380 nm และการดูดกลืนที่ความยาวคลื่นข้างเคียงนั้นจะต่ำกว่า รูปร่างพีคการดูดกลืนคลื่นแสงนั้นมีลักษณะพีคเป็นรูปร่างที่เข้ากับฟังก์ชัน Gaussian distribution (ดูบันทึกฉบับที่ ๒๖๐ และ ๒๖๓)

ที่นี้เราจะมาลองดูว่าขนาดและความกว้างของพีคที่อยู่เคียงข้างนั้นจะส่งผลอย่างไรบ้างต่อความสูงของพีคที่เราต้องการอ่านค่า

รูปแบบหนึ่งของสมการ Gaussian distribution function คือ

ในสมการข้างบน a คือ amplitude หรือความสูงของพีคที่ตำแหน่งกึ่งกลาง b คือตำแหน่งกึ่งกลางพีค และ c เป็นพารามิเตอร์ที่สัมพันธ์กับความกว้างของพีค ณ ตำแหน่งกึ่งกลางความสูง (Full Width at Half Maximum - FWHM)

สมมุติว่าเรามีพีคการดูดกลืนคลื่นแสง ๒ พีคที่อยู่ห่างกัน 20 nm โดยพีคแรกมีกึ่งกลางอยู่ที่ตำแหน่งความยาวคลื่น 380 nm (b = 380) และพีคที่สองมีกึ่งกลางอยู่ที่ตำแหน่งความยาวคลื่น 400 nm (b = 400) โดยให้พีคทั้งสองนั้นมี amplitude เท่ากันคือ 1.0 รูปที่ ๒ แสดงกราฟของพีคแต่ละพีคและพีคที่เป็นผลรวมของทั้งสองพีค เมื่อพีคนั้นมีค่า FWHM (ค่า c) แตกต่างกันไป

รูปที่ ๒ ผลรวมพีค Gaussian สองพีคที่มีศูนย์กลาง (b) อยู่ที่ตำแหน่ง 380 nm และ 400 nm และมีความสูงเท่ากันคือ a = 1.00 แต่มีค่า FWHM แตกต่างกันคือ (บนซ้าย) c = 5 (บนขวา) c = 10 (ล่าง) c = 20

ลักษณะของพีค Gaussian นั้นความกว้างที่ฐานของพีคจะประมาณ 4 เท่าของค่า FWHM (ค่า c) จากรูปที่ ๒(บนซ้าย) จะเห็นได้ว่าสำหรับพีคที่อยู่ห่างกัน 20 nm นั้นในกรณีที่ c มีค่าไม่เกิน 1/4 ของระยะห่างระหว่างศูนย์กลางของพีค (ในรูปนี้ค่า c = 5) ส่วนฐานของแต่ละพีคจะลู่เข้าหาแกน x ก่อนถึงตำแหน่งศูนย์กลางของพีคที่อยู่เคียงข้าง ถ้าพิจารณาความสูงของพีคแต่ละพีค (เส้นสีน้ำเงินกับเส้นสีส้ม) กับเส้นสัญญาณรวม (เส้นสีเขียว) จะเห็นว่าค่าความสูงที่อ่านได้นั้นไม่แตกต่างกัน

แต่พอค่า FWHM (ค่า c) เพิ่มมากขึ้น เช่นในกรณีของรูปที่ ๒(บนขวา) ที่ค่า c = 10 จะเห็นว่าสัญญาณรวมที่ได้นั้นแตกต่างไปจากสัญญาณของแต่ละพีค กล่าวคือเห็นเป็นพีคหัวป้านเพียงพีคเดียวที่มีตำแหน่งศูนย์กลางอยู่ที่ 390 nm และความสูงเพิ่มเป็น 1.213 (เพิ่มมากขึ้น 21%) และเมื่อค่า c เพิ่มมากขึ้นไปอีกเช่นเพิ่มเป็น 20 ดังกรณีที่แสดงในรูปที่ ๒(ล่าง) จะเห็นว่าพีคที่ได้นั้นจะเห็นเป็นพีคใหญ่เพียงพีคเดียวที่มีตำแหน่งศูนย์กลางอยู่ที่ประมาณ 390 nm และมีความสูง 1.765 (เพิ่มมากขึ้น 76.5%)

แต่ถ้าเราทำการ deconvolution สัญญาณรวมออกมาเป็นพีคย่อยสองพีค เราจะพบว่าทั้งสามกรณีนั้นพีคที่ตำแหน่ง 380 nm และ 400 nm มีความสูงเท่ากันคือ 1.00

รูปที่ ๓ ผลรวมพีค Gaussian สองพีคที่มีศูนย์กลาง (b) อยู่ที่ตำแหน่ง 380 nm และ 400 nm โดยคงความสูงของพีคที่ตำแหน่ง 380 nm ไว้ที่ a = 1.00 (บนซ้าย) c = 10 โดยพีคที่ 400 nm มีค่า a = 0.50 (บนขวา) c = 20 โดยพีคที่ 400 nm มีค่า a = 0.50 และ (ล่าง) c = 20 โดยพีคที่ 400 nm มีค่า a = 0.20
 
ที่นี้เราลองมาดูกรณีที่สอง โดยที่ยังคงตำแหน่งศูนย์กลางของพีคทั้งสองไว้ที่ตำแหน่งเดิม โดยในกรณีนี้เราจะลองสมมุติว่าพีคที่เราต้องการหาความสูงนั้นคือพีคที่ตำแหน่ง 380 nm แล้วเราจะมาลองดูว่าพีคข้างเคียงที่ตำแหน่ง 400 nm นั้นจะส่งผลอย่างไรต่อความสูงของพีคที่ตำแหน่ง 380 nm เมื่อพีคที่ตำแหน่ง 400 nmนั้นมีค่า a เปลี่ยนไปที่ค่า c แตกต่างกัน

ในรูปที่ ๓ จะเห็นได้ว่าเมื่อพีคมีการเหลื่อมซ้อนกัน ความสูงของพีคเล็กที่อยู่เคียงข้างสามารถส่งผลกระทบต่อความสูงของพีคใหญ่ที่อยู่ใกล้เคียงได้ เช่นในกรณีของรูปบนซ้ายที่มีค่า c = 10 พบว่าจากสัญญาณรวมนั้น (เส้นสีเขียว) จะเห็นพีคใหญ่ที่ตำแหน่งประมาณ 382 nm โดยมีความสูงประมาณ 1.079 และมีส่วนที่เป็นไหล่ (shoulder) ที่พอจะเห็นได้ที่ตำแหน่งประมาณ 400 nm แต่ถ้าหากว่าค่า c เพิ่มขึ้นเช่นเป็น 20 ดังรูปบนขวา จะเห็นเป็นพีคใหญ่พีคเดียวที่มีศูนย์กลางอยู่ที่ตำแหน่งประมาณ 382 nm และมีความสูงประมาณ 1.347 (มากกว่าที่ควรเป็นประมาณ 35%)

ส่วนรูปที่ ๓ (ล่าง) นั้นเป็นกรณีเดียวกับรูปที่ ๓ (บนขวา) เพียงแต่ลดค่า a ของพีคที่ตำแหน่ง 400 nm ลงเหลือ 0.2 ซึ่งก็พบว่าพีคสัญญาณรวมจะมีศูนย์กลางอยู่ที่ 382 nm และมีความสูงประมาณ 1.128
ต่อไปขอให้ลองพิจารณารูปที่ ๔ ดูก่อน ซึ่งเป็นกรณีผลรวมของพีคสองพีคที่มีค่า c เท่ากันคือ 20 แต่ค่า a ของพีคทั้งสองเปลี่ยนไปโดยที่ยังคงสัดส่วนของค่า a ของพีคที่ตำแหน่ง 380 และ 400 nm กล่าวคือให้ค่า a ของพีคที่ตำแหน่ง 400 nm มีค่าเพียง 60% ของค่า a ของพีคที่ตำแหน่ง 380 nm

รูปที่ ๔ พีครวมของสองพีคที่มีอัตราส่วนความสูงเท่ากัน (ซ้าย) พีคที่ 380 nm มี a = 1.00 ส่วนพีคที่ 400 nm มี a = 0.50 (ขวา) พีคที่ 380 nm มี a = 0.60 ส่วนพีคที่ 400 nm มี a = 0.30 โดยค่า c ของพีคในรูปทั้งสองเท่ากับ 20

ในกรณีที่ค่า a ของพีคที่ 380 nm มีค่าเท่ากับ 1.00 และของพีคที่ 400 nm มีค่าเท่ากับ 0.50 นั้น (รูปที่ ๔ ซ้าย) พบว่าพีครวมมียอดอยู่ที่ตำแหน่ง 386 nm และความสูง 1.347 หรือสูงกว่าความสูงของพีคที่ 380 nm อยู่ประมาณ 35% ส่วนกรณีที่ค่า a ของพีคที่ 380 nm มีค่าเท่ากับ 0.60 และของพีคที่ 400 nm มีค่าเท่ากับ 0.30 นั้น (รูปที่ ๔ ขวา) พบว่าตำแหน่งยอดของพีครวมยังคงอยู่ที่ 386 nm และความสูงเท่ากับ 0.808 หรือสูงกว่าความสูงของพีคที่ 380 nm อยู่ประมาณ 35% เช่นเดียวกัน

โครงสร้างโมเลกุลของสารอินทรีย์จากธรรมชาตินั้นมักจะมีโครงสร้างขนาดใหญ่และมีการดูดกลืนคลื่นแสงที่ความยาวคลื่นหลายตำแหน่ง แต่ในการวิเคราะห์นั้นมักจะใช้ความยาวคลื่นที่มีการดูดกลืนที่เด่นชัดมากที่สุด เช่นสมมุติว่าเรามีสารชนิดหนึ่งที่มีการดูดกลืนคลื่นแสงที่ความยาวคลื่น 380 nm และ 400 nm โดยการดูดกลืนที่ความยาวคลื่น 380 nm นั้นเด่นชัดกว่าที่ 400 nm (กรณีดังรูปที่ ๔) ในกรณีที่สารนี้มีความเข้มข้นแตกต่างกันไป ค่าการดูดกลืนที่ตำแหน่งความยาวคลื่นต่าง ๆ ก็จะเปลี่ยนแปลงไปด้วย โดยจะเปลี่ยนแปลงด้วยอัตราส่วนเดียวกัน ดังเช่นที่แสดงในรูปที่ ๔ ซึ่งเราอาจใช้ความสูงของพีคที่ความยาวคลื่น 380 nm (ต้องทำการ deconvolution สัญญาณที่ได้ก่อน) หรือความสูงของพีคสัญญาณรวม เป็นตัวระบุความเข้มข้นของสารตัวอย่างก็ได้

แต่ถ้าเป็นตัวอย่างที่ประกอบด้วยสารหลายชนิดปนกันอยู่นั้น พีคการดูดกลืนที่เกิดจากสารตัวอื่นที่ให้พีคการดูดกลืนในตำแหน่งที่ใกล้เคียงกับพีคการดูดกลืนของสารตัวอย่างที่เราต้องการวัดปริมาณ สามารถส่งผลกระทบต่อความสูงและตำแหน่งพีคการดูดกลืนของสารตัวอย่างที่เราต้องการวัดปริมาณได้ ตัวอย่างของกรณีนี้ได้แก่กรณีที่แสดงในรูปที่ ๓

สมมุติว่าสารที่เราต้องการวิเคราะห์นั้นให้พีคการดูดกลืนที่ความยาวคลื่น 380 nm แต่ในสารตัวอย่างของเรานั้นมีสารอื่นรวมอยู่ด้วยที่ให้พีคการดูดกลืนที่ความยาวคลื่น 400 nm กราฟในรูปที่ ๓ แสดงให้เห็นชัดว่าที่พีคการดูดกลืนที่ความยาวคลื่น 380 nm ที่มีขนาดคงที่ แต่ถ้าพีคการดูดกลืนที่ความยาวคลื่น 400 nm เปลี่ยนแปลงไป จะทำให้พีคผลรวมนั้นเปลี่ยนแปลงไปด้วย และการเปลี่ยนแปลงนั้นจะมากขึ้นถ้าหากพีคมีความกว้างมากขึ้น

กรณีที่แสดงในรูปที่ ๓ นั้นสามารถก่อปัญหาได้ถ้าผู้อ่านผลการทดลองคิดว่าพีคเส้นสีเขียวที่ได้มานั้นเป็นพีคการดูดกลืนที่ตำแหน่ง 380 nm เพียงพีคเดียว ทั้ง ๆ ที่ในความเป็นจริงนั้นพีคเส้นสีเขียวดังกล่าวเป็นพีครวมของการดูดกลืนที่ตำแหน่ง 380 nm (ที่เกิดจากสารที่เราต้องการวัด) และที่ตำแหน่ง 400 nm (ที่เกิดจากสารตัวอื่น) รวมกันอยู่ ดังนั้นถ้านำความสูงของพีคผลรวมที่ได้ไปแปลผลว่าเป็นของสัญญาณการดูดกลืนที่ความยาวคลื่น 380 nm เพียงพีคเดียวเท่านั้น ก็จะให้ผลที่ผิดพลาดไปจากความเป็นจริงได้มาก โดยจะทำให้อ่านค่าได้สูงกว่าความเป็นจริง (แต่บางคนอาจจะชอบ โดยเฉพาะเวลาที่ต้องการวัดปริมาณสารที่สกัดออกมาได้ เพราะมันทำให้ผลการทดลองดูดีขึ้น) แต่ถ้านำสัญญาณที่ได้นั้นไปทำการแยกพีค (deconvolution) ก่อน ก็จะเห็นผลการวัดที่แตกต่างออกไป คือจะเห็นว่าความสูงของพีคการดูดกลืนที่ความยาวคลื่น 380 nm นั้นเท่ากันหมด

ถึงตอนท้ายนี้คงมีคนสงสัยว่าพีคการดูดกลืนที่เราเคยวัดนั้นมีความกว้างเท่าใด ตัวอย่างผลการวิเคราะห์ที่เคยนำมาแสดงในรูปที่ ๒ ของ Memoir ฉบับที่ ๒๖๓ "UV-Vis - peak fitting" แสดงให้เห็นพีคที่ผ่านการ deconvolution แล้วมีค่า c ประมาณ 20 ซึ่งก็อยู่ในระดับเดียวกันกับตัวอย่างที่นำมาแสดงใน Memoir ฉบับที่ ๕๐๘ นี้